Jak wdrożyć backup i Disaster Recovery zgodny z NIS2 – krok po kroku
Backup zwykle działa: zadania kończą się sukcesem, a raporty nie pokazują błędów – dopiero po incydencie okazuje się, że nikt nie wie, co odtworzyć najpierw ani ile to potrwa. Odpowiedź na pytanie, jak wdrożyć NIS2 backup krok po kroku, zaczyna się w tym samym miejscu: kopia danych to jeszcze nie zdolność przywrócenia organizacji.
Zobacz, jakie decyzje zapadają przed wyborem technologii – od listy krytycznych usług po test potwierdzający czas powrotu!
Z tego artykułu dowiesz się:
- Dlaczego sam backup nie gwarantuje przywrócenia biznesu: Dowiesz się, jakie 4 etapy dzielą kopię zapasową od w pełni działającej usługi oraz dlaczego odzyskanie pojedynczych danych nie przywraca działania firmy bez sprawnej sieci, tożsamości i powiązanych integracji.
- Jak zdefiniować priorytety i parametry RTO/RPO dzięki BIA: Zrozumiesz, jak analiza wpływu biznesowego (BIA) i mapowanie zależności międzysystemowych pomagają ustalić realne ramy dopuszczalnego przestoju oraz akceptowalnej utraty danych dla poszczególnych systemów.
- Na czym polega skuteczna separacja administracyjna i technologia WORM: Poznasz zasady izolacji repozytoriów kopii poza domeną Active Directory, rolę obowiązkowego MFA i zasady najmniejszych uprawnień oraz dowiesz się, jak niezmienne kopie (Immutable Backup) uniemożliwiają atakującym skasowanie archiwów.
- Co musi zawierać operacyjny plan Disaster Recovery (DRP): Zobaczysz, jak model 3-2-1-1-0 porządkuje architekturę odporności oraz jak przygotować procedury awaryjne ze ściśle zdefiniowanymi rolami decyzyjnymi, kryteriami uruchomienia i kolejnością startu usług.
- Jak weryfikować zdolność powrotu do działania na 3 poziomach testów: Przekonasz się, dlaczego test pojedynczego pliku to za mało, jak mierzyć rzeczywisty czas odtworzenia całego środowiska krytycznego oraz jakich najczęstszych błędów unikać przy wdrażaniu backupu pod wymogi NIS2.
Dlaczego sam backup nie wystarcza do powrotu usługi?
Backup odpowiada na pytanie o kopię danych, a powrót usługi wymaga jeszcze sprawnej infrastruktury, poprawnej kolejności uruchamiania i działających integracji. Od wykonania kopii do momentu, w którym dział sprzedaży realnie wystawia faktury, dzielą organizację 4 odrębne etapy: wykonanie kopii, odzyskanie danych, odtworzenie infrastruktury i przywrócenie usługi biznesowej.
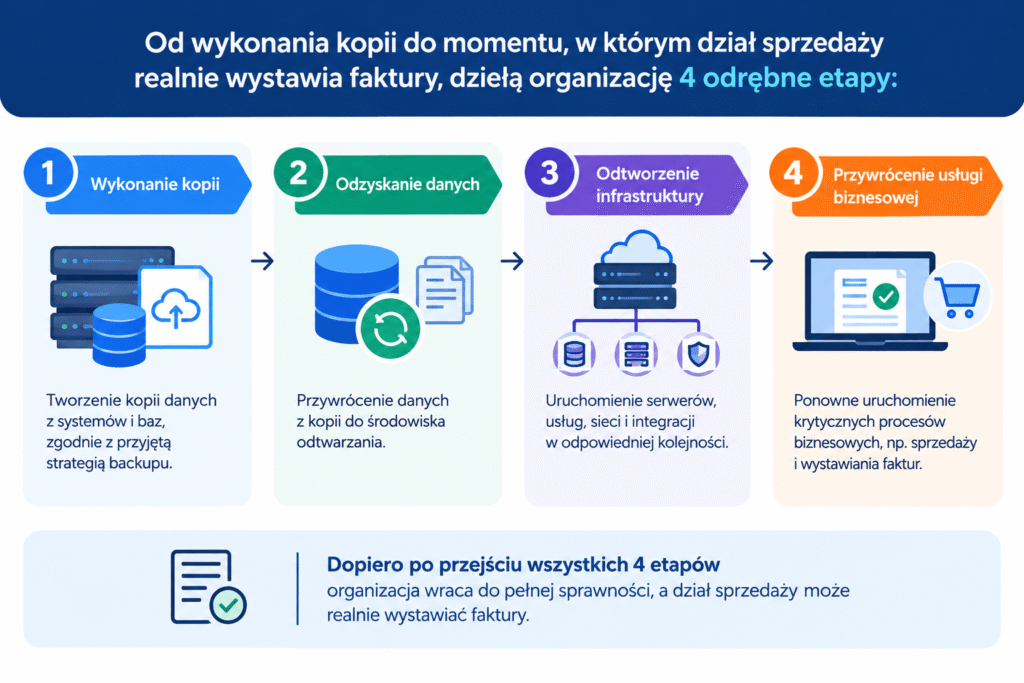
Baza danych systemu ERP wraca z kopii w godzinę, ale usługa katalogowa, DNS, sieć i macierz nadal nie odpowiadają. Formalnie dane zostały odzyskane, biznes nadal stoi. Odtworzenie nie kończy się w chwili odzyskania pliku czy maszyny wirtualnej – kończy się wtedy, gdy krytyczna usługa znowu działa.
Co NIS2 mówi o backupie i ciągłości działania?
Backup zgodny z NIS2 mieści się wśród środków zarządzania ryzykiem: dyrektywa wymienia ciągłość działania, w tym zarządzanie backupem i odtwarzanie po awarii, bez wskazywania konkretnych produktów. Zakres rozwiązań ma wynikać z ryzyka i krytyczności usług, co przesądza też, jakie wymagania NIS2 stawia backupowi i odtwarzaniu usług.
Przepisy nie milczą jednak o rozmieszczeniu kopii: rozporządzenie wykonawcze Komisji z 2024 roku wymaga od części podmiotów kopii poza siecią systemu produkcyjnego. W Polsce przepisy wdrażające NIS2 obowiązują od 3 kwietnia 2026 roku, a obowiązki liczy się od momentu, w którym organizacja spełniła przesłanki uznania za podmiot kluczowy lub ważny. Celem pozostaje zdolność odzyskania działania adekwatna do ryzyka.
Krok 1: Zidentyfikuj usługi krytyczne dla organizacji
Punktem wyjścia jest lista procesów niezbędnych do działania firmy razem z systemami, na których się opierają. Porządkuje ją Business Impact Analysis (BIA), czyli analiza skutków niedostępności: co stanie się z organizacją, jeśli usługa nie będzie działać przez godzinę, osiem godzin albo kilka dni.
W analizie warto ustalić przede wszystkim:
- Procesy krytyczne – sprzedaż, produkcja, rozliczenia, obsługa klienta.
- Systemy wspierające te procesy, z wersjami i lokalizacją.
- Skutki niedostępności – finansowe, prawne i reputacyjne.
- Właścicieli biznesowych – to oni potwierdzają wymagany poziom dostępności.
- Progi eskalacji – moment, w którym przestój staje się sprawą zarządu.
Jak mapować zależności między systemami?
Zależności ustala się od strony usługi. System ERP rzadko stoi samodzielnie – korzysta z usługi katalogowej, DNS, bazy danych, macierzy, sieci i integracji zewnętrznych. Brak jednego elementu zatrzymuje całą usługę, mimo poprawnie odzyskanych danych.
Krok 2: Wyznacz czas powrotu (RTO) i dopuszczalną utratę danych (RPO)
Parametry wyznacza się osobno dla grup systemów, bo jednakowe wymagania dla całego środowiska są zbyt kosztowne albo nierealne; praktyczny podział to trzy poziomy krytyczności. Sposób, w jaki ustala się RTO i RPO, decyduje potem o kosztach całej architektury.
Czym jest Recovery Time Objective (RTO)?
Recovery Time Objective (RTO) to docelowy maksymalny czas przywrócenia usługi. Warto od razu zapisać, od kiedy się go liczy i po czym poznajemy, że usługa wróciła.
Czym jest Recovery Point Objective (RPO)?
Recovery Point Objective (RPO) określa maksymalną akceptowalną utratę danych wyrażoną w czasie i przekłada się wprost na częstotliwość kopii.
Dla systemu ERP organizacja może przyjąć 4 godziny powrotu przy utracie danych 15 minut, a dla archiwum 48 godzin i dobę – takie wartości wyznacza analiza skutków niedostępności usługi. Wymagany poziom ustala biznes, a technologię dobiera się pod niego.
Krok 3: Sprawdź obecną architekturę backupu
Przed zakupem nowego rozwiązania opłaca się opisać stan faktyczny – większość luk widać dopiero zestawioną razem. Punktem startu bywa lista kontrolna gotowości backupu.
Przegląd powinien odpowiedzieć na pytania:
- Co jest backupowane i czego kopie nie obejmują.
- Gdzie leżą kopie i jak długo są przechowywane.
- Kto ma do nich dostęp i czy repozytorium jest w tej samej domenie administracyjnej.
- Czy kopia jest niezmienialna i czy da się ją usunąć po przejęciu konta administratora.
- Czy zadania są monitorowane i kiedy wykonano ostatnie odtworzenie próbne.
Jedno pytanie porządkuje wynik szybciej niż reszta: co stanie się z kopiami, jeżeli atakujący przejmie najbardziej uprzywilejowane konto w organizacji?
Krok 4: Zaprojektuj kopie poza podstawową domeną awarii
Kopia ma przetrwać zdarzenie, które dotknęło produkcję: pożar serwerowni, awarię macierzy, ransomware, błąd administratora. Backup w tej samej infrastrukturze może zniknąć razem z produkcją, dlatego backup offsite dla firm z jedną serwerownią bywa pierwszym krokiem podnoszącym odporność.
Separacja fizyczna, logiczna i administracyjna
Separacja fizyczna odpowiada za skutki zdarzeń w budynku, logiczna – za rozdzielenie sieci i systemów, administracyjna – za uprawnienia. Najczęściej pomijana jest ta trzecia, choć to ona decyduje, czy przejęcie jednego konta otwiera produkcję i kopie naraz.
Jak wzmocnić separację administracyjną?
Separacja administracyjna nie kończy się na osobnym koncie do backupu – chodzi o to, żeby żadne pojedyncze konto nie dawało dostępu jednocześnie do produkcji i do repozytorium kopii. W praktyce oznacza to kilka konkretnych decyzji:
- Odrębna tożsamość dla systemu backupowego – konta administracyjne backupu nie powinny należeć do tej samej domeny (np. Active Directory) co produkcja. Jeśli atakujący przejmie domenę produkcyjną, nie powinien tym samym zyskać dostępu do kopii.
- MFA na każdym koncie z dostępem do backupu – logowanie do konsoli backupowej, zmiana retencji, usuwanie punktów przywracania i dostęp do repozytorium offsite powinny wymagać drugiego składnika uwierzytelnienia. To pojedynczy mechanizm, który najskuteczniej blokuje scenariusz „przejęte hasło administratora = skasowane kopie”.
- Least privilege zamiast kont uniwersalnych – operator wykonujący codzienne zadania backupowe nie potrzebuje uprawnień do zmiany polityk retencji ani usuwania repozytoriów. Rozdzielenie ról (operator / administrator retencji / administrator infrastruktury) ogranicza skutki przejęcia pojedynczego konta.
- Brak trwałych uprawnień administracyjnych – tam, gdzie to możliwe, warto stosować dostęp czasowy (just-in-time) zamiast stałych uprawnień administratora, żeby konto skompromitowane poza „oknem” dostępu nie dawało nic atakującemu.
- Osobne logowanie i alertowanie zmian retencji – każda próba skrócenia retencji lub usunięcia kopii poza standardową procedurą powinna generować alert, niezależnie od tego, czy działanie zakończyło się sukcesem.
Kiedy immutable backup naprawdę chroni kopie?
Immutable backup to kopia w trybie WORM, niemożliwa do zmiany ani usunięcia przez zadany czas. Chroni wtedy, gdy działa razem z odseparowanym repozytorium i kontrolą zmian retencji.
Znane są incydenty ze skasowaniem kopii w ośrodku podstawowym i zapasowym naraz, więc sama druga lokalizacja nie wystarcza. Pytanie brzmi: czy po przejęciu środowiska intruz usunie kopię albo skróci jej retencję? Dopiero „nie” pozwala mówić o backupie odpornym na ransomware.
Model 3-2-1-1-0 jako wzorzec projektowy
Model porządkuje architekturę kopii w pięciu punktach:
- 3 kopie danych – oryginał i dwie kopie zapasowe.
- 2 różne typy nośników lub systemów przechowywania.
- 1 kopia poza lokalizacją podstawową.
- 1 kopia offline albo niezmienialna.
- 0 błędów potwierdzonych weryfikacją i odtworzeniem próbnym.
To model projektowy, który podnosi odporność architektury kopii – wymusza pytania o media, lokalizację i weryfikację. Jako całość nie jest wymogiem żadnego przepisu. Europejskie wytyczne rekomendują podobnie, zostawiając dobór rozwiązań organizacji.
Krok 5: Przygotuj Disaster Recovery Plan i środowisko odtworzeniowe
Plan mówi, kto i w jakiej kolejności działa, środowisko – na czym systemy zostaną uruchomione.
Co zawiera Disaster Recovery Plan (DRP)?
Disaster Recovery Plan (DRP) prowadzi zespół przez incydent w ustalonej kolejności:
- Warunki uruchomienia – kto ogłasza tryb odtwarzania.
- Role i odpowiedzialności z osobami kontaktowymi.
- Priorytety i kolejność odtwarzania.
- Procedury techniczne dla każdej warstwy.
- Komunikacja wewnętrzna, z klientami i z organami.
- Kryteria zakończenia – po czym uznajemy, że usługa wróciła.
Dokument ma być instrukcją działania, a nie załącznikiem na audyt; jak połączyć go z szerszym planem ciągłości działania, opisujemy osobno.
Gdzie uruchomić systemy po utracie lokalizacji?
Do wyboru jest kilka modeli: własna infrastruktura zapasowa, drugi ośrodek, odtwarzanie w chmurze, DRaaS ze środowiskiem zapasowym albo hybryda. Wybór wynika z wymaganego czasu powrotu, utraty danych i kosztu przestoju.
Disaster Recovery dla firm bez drugiego ośrodka zwykle opiera się na infrastrukturze usługodawcy, a wybrane środowisko przesądza o tym, jak wygląda plan disaster recovery po stronie technicznej.
Krok 6: Przetestuj rzeczywistą zdolność odtworzenia
Testy odtworzeniowe sprawdzają trzy różne rzeczy i warto je rozdzielić. Każdy kończy się raportem ze zmierzonym czasem odtworzenia i działaniami naprawczymi. Praktyka sprawdzania, czy backup naprawdę działa, różni się przy pojedynczym pliku i przy odtworzeniu całego środowiska.
Test pojedynczego backupu
Sprawdza, czy da się odzyskać konkretny plik albo maszynę wirtualną – to najniższy poziom weryfikacji.
Test systemowy
Obejmuje kompletną aplikację z bazą i integracjami. Maszyna może się uruchomić, a aplikacja nadal nie przyjmować zamówień.
Test Disaster Recovery
Weryfikuje odtworzenie krytycznego środowiska w zadanej kolejności. Deklarowany czas powrotu staje się rzeczywistym dopiero wtedy, gdy organizacja zmierzy go w praktyce.
Krok 7: Monitoruj backup i utrzymuj proces po wdrożeniu
Repozytorium kopii wymaga takiego samego nadzoru jak produkcja. Monitorować trzeba nieudane zadania, anomalie w wolumenie danych, próby usunięcia punktów przywracania i zmiany retencji. Nagłe zmiany wolumenu danych, nietypowy wzrost liczby zmodyfikowanych plików lub inne anomalie w zadaniach backupowych mogą być sygnałem incydentu.
Plan aktualizuje się po zmianach infrastruktury, migracjach, testach i realnych incydentach. Procedura nieprzeglądana przez dwa lata opisuje zwykle środowisko, które już nie istnieje.
Podział ról: wykrywanie i odzyskiwanie
VigilHorizon pomaga wykryć incydent i rozpocząć reakcję – prowadzi monitoring oraz centrum operacji bezpieczeństwa i sieci. SecureVault zapewnia warstwę potrzebną do odzyskania działania: kopie poza lokalizacją produkcyjną, kopie niezmienialne, odtwarzanie i potwierdzone parametry powrotu.
Od backupu do odporności – co odpowiada na które pytanie?
Każdy element architektury odpowiada na inne pytanie organizacji:
| Element | Na jakie pytanie odpowiada |
|---|---|
| BIA | Co jest krytyczne dla biznesu? |
| RTO | Jak szybko usługa musi wrócić? |
| RPO | Ile danych możemy utracić? |
| Backup | Czy mamy kopię danych? |
| Backup offsite | Czy kopia przetrwa utratę lokalizacji? |
| Kopia niezmienialna | Czy atakujący ją usunie? |
| Disaster Recovery Plan | Jak przeprowadzimy odtworzenie? |
| Środowisko odtworzeniowe | Gdzie uruchomimy systemy? |
| Testy odtworzeniowe | Czy odtworzenie działa? |
| Monitoring | Czy wykryjemy incydent? |
Model referencyjny układa je w sekwencję: produkcja, szybkie odtwarzanie lokalne, backup, kopia poza lokalizacją, kopia niezmienialna, środowisko odtworzeniowe i testy – spięte monitoringiem i odpowiedzialnością.
Najczęstsze błędy przy wdrażaniu backupu i DR
Powtarzają się niezależnie od branży i wielkości firmy:
- „Backup działa, więc jesteśmy przygotowani” – status SUCCESS mówi tylko o wykonaniu zadania.
- Kopie w tej samej infrastrukturze – jedno zdarzenie obejmuje produkcję i backup.
- Brak kopii niezmienialnej – atakujący może skasować repozytorium.
- Wspólna domena administracyjna – jedno konto otwiera kilka warstw.
- Parametry z możliwości systemu zamiast z wymagań biznesu.
- Plan wyłącznie na papierze – nigdy nieuruchomiony w testach.
- Test jednej maszyny zamiast usługi – serwer wstaje, aplikacja nie działa.
- Brak właściciela procesu – nikt nie odpowiada za całość.
Jak wygląda incydent w firmie bez przetestowanego odtwarzania?
Firma ma środowisko wirtualne, lokalną macierz, system backupowy i codzienne kopie, a zarząd przyjmuje, że temat jest zabezpieczony. Brakuje jednak parametrów powrotu, analizy skutków przestoju, kopii poza lokalizacją i przećwiczonej procedury.
Ransomware obejmuje część produkcji, konta administracyjne i lokalne repozytorium kopii. Dział IT odzyskuje dane, ale kolejność odtwarzania ustala w trakcie, więc ERP wraca po kilkudziesięciu godzinach zamiast po kilku. Zawiódł proces odtwarzania, którego nikt wcześniej nie zaprojektował ani nie sprawdził.
Od czego zacząć wdrożenie u siebie?
Kolejność prac jest odwrotna niż w większości wdrożeń zaczynających się od porównywania systemów backupowych. Najpierw trzeba ustalić, co musi przetrwać incydent, w jakim czasie ma wrócić i ile danych wolno stracić – dopiero te odpowiedzi mówią, jakiej architektury i jakiego zakresu testów firma potrzebuje.
Pierwszy krok jest prosty: wybierz trzy najważniejsze usługi i zapisz dla każdej wymagany czas powrotu oraz dopuszczalną utratę danych. Jeśli chcesz zweryfikować architekturę backupu i odtwarzania, zacznij od audytu zgodności z NIS2 – pokażemy, które elementy odporności już działają, a czego brakuje!
Najczęściej zadawane pytania (FAQ)
Zobacz również

Nie wiesz który pakiet jest odpowiedni dla twojej firmy?
Wypełnij krótką ankietę
Wypełnij krótki formularz, a pomożemy Ci wybrać rozwiązanie, które realnie
ochroni Twoją firmę i zapewni jej ciągłość działania nawet w przypadku awarii.