Snapshot vs backup – dlaczego snapshot nie jest Disaster Recovery
Awaria macierzy zatrzymuje kluczowe systemy. Zespół IT zakłada, że szybko cofnie środowisko do ostatnich snapshotów. Dopiero podczas próby odzyskania okazuje się, że migawki znajdowały się na tej samej infrastrukturze i stały się niedostępne razem z produkcją. Problemem nie był sam mechanizm snapshotów. Problemem było założenie, że stanowi on niezależną kopię danych.
Podobny błąd ujawnia się po ransomware, usunięciu wolumenu albo przejęciu konta administracyjnego. Lista punktów przywracania nie odpowiada jeszcze na pytanie, czy firma odzyska dane po utracie platformy źródłowej. Tym bardziej nie potwierdza, że przywróci aplikacje, tożsamość, sieć i zależności w czasie akceptowalnym dla biznesu.
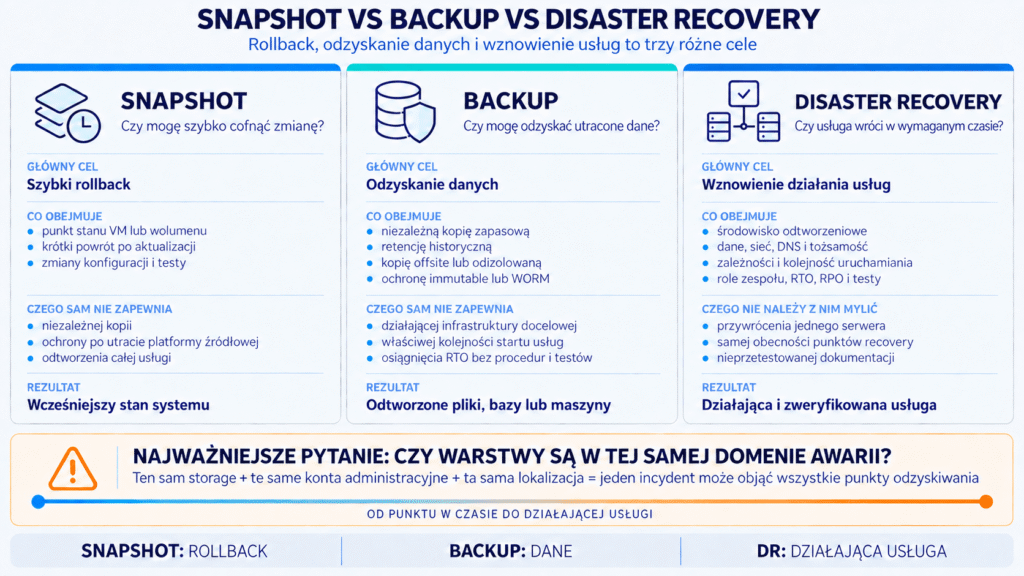
Problemem nie jest używanie snapshotów. Problemem jest traktowanie ich jako backupu lub planu Disaster Recovery. Snapshot ułatwia szybki rollback, backup umożliwia odzyskanie danych, a Disaster Recovery służy do wznowienia działania usług.
Co warto wiedzieć:
- Snapshot zapisuje stan systemu w określonym punkcie czasu, ale jego samodzielność zależy od technologii i architektury.
- Snapshot VMware nie jest backupem. Plik zmian pozostaje zależny od dysku bazowego maszyny.
- Backup powinien przetrwać utratę źródła, lecz sama nazwa „backup” nie zapewnia separacji.
- Disaster Recovery obejmuje dane, infrastrukturę, sieć, tożsamość, zależności, role i testy.
- Recovery Time Objective (RTO) określa akceptowalny czas niedostępności, a Recovery Point Objective (RPO) dopuszczalny zakres utraty danych liczony w czasie.
- NIS2 obejmuje ciągłość działania, zarządzanie backupem i Disaster Recovery, ale nie narzuca jednej technologii.
Czym jest snapshot?
Snapshot, czyli migawka, przedstawia stan wolumenu, systemu plików albo maszyny wirtualnej w określonym punkcie czasu. Nie zawsze jest drugą, pełną kopią wszystkich danych. Sposób działania zależy od platformy: część rozwiązań zapisuje metadane i zachowuje wcześniejsze bloki, a część prowadzi plik zmian powiązany z obrazem bazowym.
W mechanizmie copy-on-write pierwotna wersja bloku jest zachowywana przed zmianą. W redirect-on-write nowy zapis trafia do innej lokalizacji, a migawka nadal wskazuje poprzedni stan. Oba podejścia pozwalają szybko utworzyć punkt w czasie bez natychmiastowego kopiowania całego zasobu, ale różnią się zależnościami i sposobem odtwarzania.
Zgodnie z dokumentacją Broadcom snapshot VMware przechowuje dziennik zmian względem dysku bazowego i nie wystarcza do odtworzenia maszyny po jego utracie. Z kolei NetApp opisuje własną migawkę jako obraz wolumenu tylko do odczytu, oparty na metadanych i blokach współdzielonych z aktywnym systemem plików. Nie należy więc zakładać, że wszystkie snapshoty działają identycznie.
Znaczenie ma także spójność. Snapshot może odwzorowywać stan podobny do nagłego odcięcia zasilania albo zostać skoordynowany z aplikacją. Samo utworzenie migawki nie potwierdza, czy baza danych uruchomi się poprawnie po cofnięciu.
Do czego snapshot naprawdę służy?
Snapshot jest dobrym narzędziem, gdy administrator potrzebuje krótkiej drogi powrotu po kontrolowanej zmianie. Typowe zastosowania to aktualizacja, instalacja poprawki, modyfikacja konfiguracji, migracja, okno serwisowe oraz testy administracyjne.
Przed aktualizacją ERP administrator może utworzyć snapshot maszyny. Jeśli zmiana powoduje problem, migawka pozwala szybko wrócić do wcześniejszego stanu. To prawidłowe użycie: snapshot rozwiązuje problem krótkoterminowego rollbacku.
Nie oznacza to jednak, że powinien być przechowywany bezterminowo. Długie łańcuchy mogą wpływać na pojemność, wydajność lub złożoność, zależnie od technologii. Czas retencji trzeba ustalać na podstawie dokumentacji producenta, obciążenia i celu biznesowego. Jeśli firma chce odzyskać dane po utracie platformy, potrzebuje niezależnego backupu. Jeśli chce wznowić usługę wraz z zależnościami, potrzebuje Disaster Recovery.
Snapshot vs backup – różnice
Porównanie „snapshot a backup” nie powinno opierać się tylko na szybkości. Ważniejsze są granice awarii, retencja, ochrona administracyjna i to, co zespół rzeczywiście potrafi odtworzyć.
| Cecha | Snapshot | Backup | Disaster Recovery |
|---|---|---|---|
| Główny cel | Szybki punkt w czasie i rollback | Odzyskanie danych | Odtworzenie działania usługi |
| Niezależna kopia | Nie z definicji | Powinna nią być | Korzysta z odseparowanych kopii lub replik |
| Offsite | Możliwe, nie jest domyślne | Zalecane dla ważnych danych | Uwzględnia utratę lokalizacji podstawowej |
| Immutable | Zależy od platformy | Może wykorzystywać immutable lub WORM | Powinno korzystać z odpornych punktów recovery |
| Awaria storage | Może odebrać dostęp do migawki | Odseparowana kopia pozostaje dostępna | Zakłada odtworzenie środowiska |
| Ransomware | Ryzyko przy wspólnym zarządzaniu | Odporność zależy od separacji i retencji | Obejmuje wybór bezpiecznego punktu i czyste odtworzenie |
| Odtworzenie usług | Nie | Nie zawsze | Tak, wraz z zależnościami |
| RTO i RPO | Nie definiuje | Wpływa na możliwy wynik | Strategia jest projektowana pod te cele |
| Testy | Zwykle rollback techniczny | Powinny potwierdzać odzyskanie danych | Potwierdzają wznowienie usługi |
Backup również może być źle zaprojektowany. Repozytorium na tej samej macierzy, dostępne przez te same konta i stale połączone z siecią produkcyjną, pozostaje podatne na wiele tych samych zdarzeń. Różnicę tworzy rzeczywista niezależność, nie nazwa produktu.
Domena awarii
Domena awarii, czyli failure domain, obejmuje zasoby, które mogą przestać działać wskutek jednego zdarzenia. Może nią być macierz, klaster, serwerownia, usługa katalogowa, tenant chmurowy, konsola zarządzająca albo zestaw poświadczeń administracyjnych.
Nie wystarczy zapytać: „czy mamy snapshot?”. Trzeba zapytać: „czy punkt odtworzenia pozostanie dostępny po utracie systemu źródłowego, platformy zarządzającej lub konta administratora?”.
| Wspólna zależność | Możliwy skutek | Pytanie kontrolne |
|---|---|---|
| Ten sam storage | Utrata produkcji i snapshotów | Czy kopia istnieje poza tym systemem? |
| Ten sam hypervisor lub vCenter | Brak VM i narzędzi zarządzania | Czy odzyskamy dane bez platformy źródłowej? |
| Ta sama serwerownia | Jedno zdarzenie fizyczne obejmuje całość | Czy istnieje kopia w innej lokalizacji? |
| Te same konta | Jedno przejęte konto usuwa wiele warstw | Czy backup ma odrębne tożsamości i MFA? |
| Ten sam IAM lub Active Directory | Brak logowania do recovery | Czy istnieje niezależny dostęp awaryjny? |
Kilka mechanizmów przechowywania nie oznacza kilku niezależnych warstw bezpieczeństwa. W audycie trzeba mapować także przepływ uprawnień oraz możliwość wykonywania operacji destrukcyjnych.
Dlaczego snapshot nie jest Disaster Recovery?
Disaster Recovery nie oznacza odzyskania pojedynczej maszyny. Oznacza przywrócenie usługi biznesowej po poważnym zdarzeniu. Snapshot sam nie zapewnia alternatywnej infrastruktury, sieci, DNS, systemu tożsamości, licencji, połączeń z systemami zewnętrznymi ani kolejności uruchamiania.
Można odzyskać bazę ERP, ale jeśli nie działa Active Directory, DNS, sieć, serwer aplikacyjny lub system licencyjny, firma nadal nie odzyskała ERP. Plan DR powinien określać systemy, zależności, priorytety, lokalizację docelową, odpowiedzialność, komunikację i kryteria potwierdzające dostępność usługi. Szerzej opisuje to materiał Plan Disaster Recovery i BCP.
Snapshot może być jednym ze źródeł recovery. Nie jest jednak planem, środowiskiem docelowym ani dowodem, że organizacja zakończy proces w wymaganym czasie.
Trzy poziomy recovery
| Warstwa | Pytanie | Rezultat |
|---|---|---|
| Snapshot | Czy mogę szybko cofnąć zmianę? | Wcześniejszy stan wolumenu lub VM |
| Backup | Czy mogę odzyskać dane po utracie źródła? | Pliki, baza, VM lub konfiguracja |
| Disaster Recovery | Czy wznowię usługę w wymaganym czasie? | Działająca usługa wraz z zależnościami |
Snapshot służy do rollbacku. Backup służy do odzyskania danych. Disaster Recovery służy do odzyskania działania organizacji.
Jak ransomware wpływa na snapshoty
Ransomware nie musi szyfrować samego snapshotu. Wystarczy, że osoba atakująca przejmie konto pozwalające usuwać punkty, zmieni retencję albo odetnie dostęp do platformy. Ryzyko rośnie, gdy produkcja, hypervisor, storage i backup podlegają jednej domenie administracyjnej.
W modelowym scenariuszu atakujący uzyskuje uprawnienia do środowiska wirtualizacji lub konsoli backupowej, usuwa snapshoty, wyłącza zadania ochrony, a następnie szyfruje produkcję i próbuje usunąć lokalne kopie. Ochrona recovery powinna więc obejmować osobne konta, MFA, ograniczenie dostępu sieciowego, retencję, alerty i procedury awaryjne. Więcej przykładów zawiera artykuł Dlaczego backup nie działa po ransomware.
Kopia może pozostać nienaruszona, ale pochodzić z czasu, gdy atakujący był już obecny w środowisku. Recovery wymaga analizy osi czasu, wyboru bezpiecznego punktu i kontrolowanego uruchomienia. Sama lista snapshotów nie potwierdza ich przydatności.
Backup offsite i immutable backup
Backup offsite znajduje się poza podstawową lokalizacją lub środowiskiem produkcyjnym. Odległość chroni przed utratą serwerowni, ale przy cyberataku równie ważna jest separacja logiczna i administracyjna. Kopia w innym budynku zarządzana przez to samo przejęte konto nadal może należeć do wspólnej domeny ryzyka.
Immutable backup jest chroniony przed zmianą lub usunięciem przez ustalony czas. Ogranicza skutki ransomware i błędu administratora, lecz nie zastępuje właściwej retencji, kontroli dostępu ani testów. Niezmienna kopia może być niekompletna, niespójna lub pochodzić z okresu incydentu.
Model 3-2-1-1-0 porządkuje architekturę:
- 3 kopie danych, licząc produkcję;
- 2 różne systemy lub rodzaje nośników;
- 1 kopia offsite;
- 1 kopia offline, odizolowana lub niezmienna;
- 0 błędów potwierdzonych weryfikacją recovery.
To dobra praktyka, nie przepis prawny ani gwarancja. Trzeba ją dopasować do ryzyka, retencji i czasu odtworzenia. Znaczenie separacji szerzej opisuje Backup offsite w NIS2.
Backup a Disaster Recovery
Backup dostarcza dane do odzyskania. Disaster Recovery odpowiada także na pytania: gdzie je uruchomimy, jakie zależności powstaną wcześniej, kto podejmuje decyzję, jak ograniczamy ryzyko ponownego uruchomienia zagrożenia i kiedy usługa jest gotowa dla użytkowników.
RTO określa maksymalny akceptowalny czas niedostępności, a RPO maksymalny akceptowalny okres utraty danych. Tak definiuje te pojęcia Microsoft Azure Well-Architected Framework. Modelowe RTO równe 4 godziny i RPO równe 15 minut oznaczają oczekiwany powrót usługi w 4 godziny oraz stan danych nie starszy niż 15 minut. Wartości muszą wynikać z potrzeb biznesowych.
Snapshot może zapewniać gęste punkty w czasie, ale nie definiuje RTO ani RPO. RTO obejmuje cały proces aż do wznowienia usługi. AWS Well-Architected Framework opisuje backup i redundancję jako początek strategii DR, która musi odpowiadać celom biznesowym i być testowana.
Bezpieczny model ochrony danych
| Warstwa | Funkcja | Warunek wiarygodności |
|---|---|---|
| Snapshot | Krótkoterminowy rollback | Kontrolowana retencja i znajomość platformy |
| Backup | Odzyskanie danych | Separacja, retencja i spójność |
| Odporna kopia | Ochrona przed usunięciem | Izolacja lub niezmienność i odrębna administracja |
| Disaster Recovery | Odtworzenie usług | Infrastruktura, procedury, role, RTO i RPO |
| Testy | Potwierdzenie procesu | Udokumentowany wynik i działania naprawcze |
Test nie powinien kończyć się na komunikacie „backup wykonany poprawnie”. Powinien sprawdzić odczyt danych, start aplikacji, zależności, integralność, dostęp użytkowników i czas wykonania. Wynik musi zawierać datę, zakres, punkt recovery, zmierzony czas, błędy i właściciela poprawek. Praktyczne przygotowanie opisuje artykuł Jak przygotować środowisko do testów odtworzeniowych backupu i DR.
Backup bez testu pozostaje założeniem, że dane uda się odzyskać. Plan DR bez ćwiczeń pozostaje założeniem, że ludzie, procedury i infrastruktura zadziałają razem.
Najczęstsze błędy
Snapshot jako jedyny backup
Mechanizm rollbacku ma przetrwać utratę całej platformy, choć często zależy od dysku bazowego, macierzy lub hypervisora.
Produkcja i snapshoty na tym samym storage
Konfiguracja może być poprawna dla rollbacku, ale nie daje niezależnej kopii po utracie urządzenia.
Backup i produkcja pod tymi samymi kontami
Oddzielne urządzenie nie wystarczy, jeśli jedno konto może usunąć produkcję, snapshoty i kopie.
Replikacja traktowana jak pełny backup
Replikacja zwiększa dostępność, ale może przenieść usunięcie lub uszkodzenie do drugiej lokalizacji. Potrzebna jest retencja historyczna.
Brak odpornej kopii i testów
Wszystkie punkty można usunąć z jednej konsoli, a błędy odtworzenia wychodzą dopiero podczas realnego zdarzenia.
Brak planu DR
Dane istnieją, lecz zespół nie wie, gdzie je uruchomić, w jakiej kolejności i kto zatwierdza przełączenie.
Kiedy snapshot ma sens
Snapshot warto stosować przed aktualizacją, patchowaniem, zmianą konfiguracji, migracją, krótkim oknem serwisowym lub testem. Trzeba określić właściciela, retencję, sposób usunięcia oraz wpływ na wydajność i pojemność. Dla maszyn wirtualnych należy uwzględnić spójność aplikacji i proces konsolidacji.
Replikowany snapshot może zwiększyć odporność, jeśli trafia do innego systemu, ma odrębne uwierzytelnianie, retencję, ochronę przed usunięciem i sprawdzony proces odzyskania. Nadal trzeba potwierdzić, czy umożliwia odtworzenie po utracie źródła. Sama replikacja nie rozstrzyga, czy mechanizm pełni funkcję backupu.
Snapshot i NIS2
Dyrektywa NIS2 wymaga stosowania adekwatnych i proporcjonalnych środków zarządzania ryzykiem. Art. 21 ust. 2 lit. c dyrektywy 2022/2555 wskazuje ciągłość działania, zarządzanie backupem, Disaster Recovery i zarządzanie kryzysowe.
Nie oznacza to obowiązku użycia jednego produktu, kopii offsite lub immutable w każdym środowisku. Nie należy też pisać, że „snapshot nie spełnia NIS2”, ponieważ ocenie podlega cały model zarządzania ryzykiem i właściwe przepisy krajowe.
Sam snapshot zwykle nie wystarcza do wykazania zdolności odzyskania danych i usług po utracie źródła. Organizacja powinna uzasadnić dobór środków, opisać separację, przedstawić procedury i wyniki testów. Liczy się potwierdzona zdolność recovery, nie sama obecność technologii.
Modelowe case study
Firma ma klaster VMware, centralną macierz, snapshoty VM i lokalny backup. Wszystkimi warstwami zarządza za pomocą tożsamości powiązanych z jedną usługą katalogową, a repozytorium jest stale osiągalne z sieci administracyjnej.
Po przejęciu konta osoba atakująca uzyskuje dostęp do vCenter, usuwa snapshoty, wyłącza zadania backupowe i szyfruje produkcję. Firma miała trzy mechanizmy, ale jedną domenę administracyjną.
W odporniejszym wariancie snapshoty nadal służą do rollbacku, backup trafia do odseparowanego repozytorium offsite, usuwanie wymaga osobnej tożsamości, wybrane punkty są niezmienne, a zespół testuje aplikację w izolowanym środowisku. Plan określa kolejność uruchomienia tożsamości, DNS, bazy, aplikacji i integracji. Różnicę tworzą niezależność oraz sprawdzony proces, nie sama liczba kopii.
Podsumowanie
Snapshot może szybko cofnąć zmianę, ale nie należy zakładać, że jest niezależną kopią lub kompletnym mechanizmem odtworzeniowym. Backup ma odzyskać dane po utracie źródła, a Disaster Recovery przywrócić działanie usługi wraz z infrastrukturą, tożsamością, siecią i zależnościami.
Odporność powstaje, gdy warstwy mają rozdzielone funkcje i granice awarii: snapshot służy do rollbacku, backup jest odseparowany od produkcji, wybrane kopie są chronione przed zmianą, a plan DR opiera się na RTO, RPO i testach. Punkt przywracania nie jest jeszcze dowodem, że organizacja potrafi go użyć w kryzysie.
Warto więc analizować całą architekturę recovery, a nie tylko status zadań. SecureVault może pomóc zweryfikować domeny awarii, separację, retencję, ochronę administracyjną, RTO/RPO oraz scenariusze testów dla systemów i infrastruktury, które organizacja musi zachować po incydencie.
Najczęściej zadawane pytania (FAQ)
Dowiedz się więcej
- Backup offsite w NIS2
- Dlaczego backup nie działa po ransomware
- Jak przygotować środowisko do testów odtworzeniowych backupu i DR
- Plan Disaster Recovery i BCP
- Odtwarzanie po awarii
Źródła
Zobacz również

Nie wiesz który pakiet jest odpowiedni dla twojej firmy?
Wypełnij krótką ankietę
Wypełnij krótki formularz, a pomożemy Ci wybrać rozwiązanie, które realnie
ochroni Twoją firmę i zapewni jej ciągłość działania nawet w przypadku awarii.